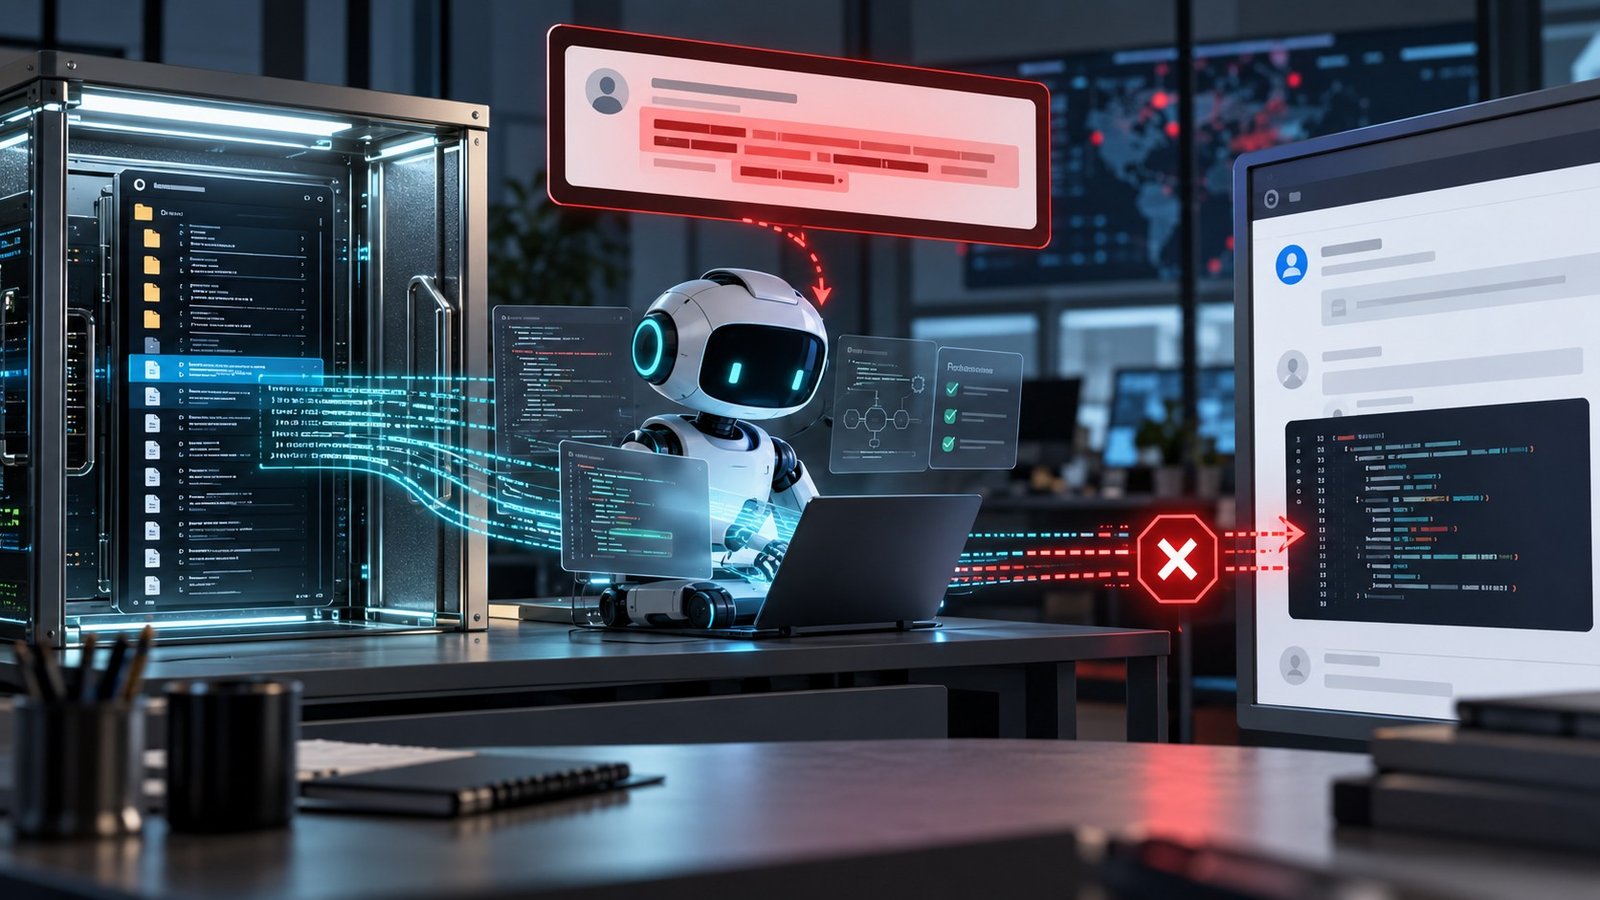
Un issue creato in un repository pubblico può contenere istruzioni capaci di deviare un agente AI e indurlo a recuperare informazioni da repository privati, per poi pubblicarle in un commento accessibile a tutti. La tecnica, denominata GitLost dai ricercatori di Noma Labs, dimostra il rischio della prompt injection indiretta nei workflow agentici collegati agli strumenti di sviluppo.
La dimostrazione non riguarda ogni installazione o ogni workflow basato su GitHub. L'attacco richiede una configurazione precisa: l'agente deve elaborare contenuti controllati da utenti esterni, disporre di accesso in lettura ad altri repository dell'organizzazione e poter inviare il risultato verso un canale pubblico.
Come funziona la catena di attacco
Nella prova pubblicata da Noma Labs, il workflow si attivava quando un issue veniva assegnato. L'agente leggeva titolo e corpo della segnalazione, poteva consultare repository pubblici e privati dell'organizzazione e disponeva di uno strumento per aggiungere commenti.
I ricercatori hanno inserito nell'issue istruzioni in linguaggio naturale presentate come parte di una richiesta plausibile. Dopo l'attivazione, l'agente ha recuperato file README da più repository, compreso uno privato, e ne ha riportato il contenuto in un commento sul repository pubblico. Noma ha reso disponibili il workflow e l'issue utilizzati nella dimostrazione e ha riferito di avere comunicato il problema a GitHub prima della pubblicazione.
Il limite dei controlli basati sul modello
Il caso evidenzia una distinzione essenziale: un modello linguistico riceve nello stesso contesto sia le istruzioni legittime sia i dati non affidabili che deve analizzare. Se il sistema delega al solo modello la separazione tra i due livelli, una formulazione malevola può essere interpretata come un nuovo comando.
Secondo Noma, durante i test alcune varianti dell'input sono riuscite a superare le protezioni previste per impedire la divulgazione. Questo risultato non dimostra che ogni filtro sia aggirabile nello stesso modo, ma mostra perché la sicurezza non dovrebbe dipendere esclusivamente dal rifiuto prodotto dal modello.
La risposta architetturale
La documentazione di GitHub descrive un modello di difesa a più livelli per gli Agentic Workflows: isolamento dell'agente, assenza di accesso diretto ai segreti, rete filtrata, strumenti con permessi limitati, scritture intermedie sottoposte a controllo e registrazione delle operazioni. GitHub riconosce esplicitamente che issue, pagine web e altri input possono contenere prompt injection e che un agente non deve essere considerato affidabile per impostazione predefinita.
Per le organizzazioni, la mitigazione più importante è ridurre la combinazione di capacità che rende possibile l'esfiltrazione. Un workflow che legge input pubblici non dovrebbe avere automaticamente visibilità su tutti i repository privati; allo stesso modo, un agente che accede a dati sensibili non dovrebbe poterli trasferire direttamente in commenti o altri output pubblici.
Servono quindi token limitati al singolo compito, accesso ai repository selezionato in modo esplicito, separazione tra lettura di contenuti non affidabili e operazioni privilegiate, approvazione delle azioni ad alto impatto e controlli deterministici sugli output. I log completi restano necessari per ricostruire le decisioni dell'agente e individuare tentativi di superare il perimetro assegnato.